

Η Τεχνητή Νοημοσύνη προγραμματίζει την... Τεχνητή Νοημοσύνη: Το πείραμα του MIT
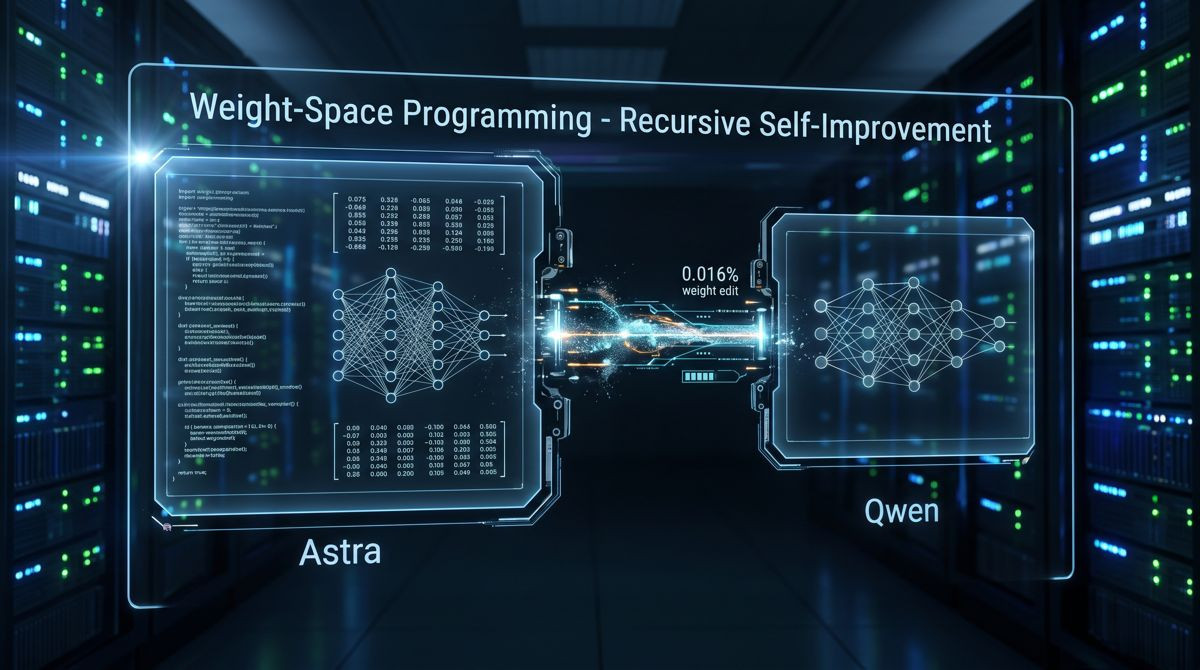
Το GPT-6 Astra της OpenAI κατάφερε να διαβάσει και να τροποποιήσει αυτόνομα τα βάρη του μοντέλου Qwen, αυξάνοντας δραματικά την απόδοση του στα μαθηματικά.
Σύνοψη
- Το GPT-6 Astra απέδειξε την ικανότητα να διαβάζει και να τροποποιεί ακατέργαστα βάρη νευρωνικών δικτύων, κατανοώντας τη λειτουργία τους αναλύοντας τεράστια σύνολα αριθμών ως απλό κείμενο.
- Ερευνητές του MIT CSAIL διαπίστωσαν ότι το μοντέλο της OpenAI εντόπισε και διόρθωσε ένα σφάλμα συλλογισμού στο σύστημα Qwen3.5-0.8B, παρεμβαίνοντας χειροκίνητα σε μόλις 0,016% των παραμέτρων του.
- Η στοχευμένη διόρθωση εκτόξευσε το ποσοστό επιτυχίας του Qwen στο μαθηματικό benchmark MATH-500 από το 7,9% στο εντυπωσιακό 48,1%, παρακάμπτοντας εντελώς την παραδοσιακή διαδικασία επανεκπαίδευσης.
- Τα ευρήματα φέρνουν στο προσκήνιο τις έντονες ανησυχίες του CEO της Anthropic γύρω από την «αναδρομική αυτοβελτίωση», προειδοποιώντας για κινδύνους απώλειας ελέγχου στα συστήματα επόμενης γενιάς.
Οι ερευνητές του εργαστηρίου MIT CSAIL προχώρησαν πρόσφατα σε μια δημοσίευση που αποδεικνύει την ικανότητα του GPT-6 Astra να διαβάζει και να τροποποιεί απευθείας τα εσωτερικά βάρη άλλων νευρωνικών δικτύων, καταργώντας πλήρως την ανάγκη για εξαιρετικά δαπανηρούς βρόχους επανεκπαίδευσης.
Η μελέτη με τίτλο Sparks of Weight-Space Programming εξηγεί αναλυτικά πώς μεγάλα γλωσσικά μοντέλα αποκτούν πλέον τη μοναδική δυνατότητα να κατανοούν τα ακατέργαστα μαθηματικά στοιχεία αντίπαλων ή μικρότερων συστημάτων και να παρεμβαίνουν στον ίδιο τον πυρήνα της αρχιτεκτονικής τους. Μέχρι σήμερα, η βελτιστοποίηση των μοντέλων τεχνητής νοημοσύνης αποτελούσε αποκλειστικό προνόμιο παραδοσιακών αλγορίθμων, όπως ο Adam ή ο Muon, οι οποίοι απαιτούσαν τεράστιους υπολογιστικούς πόρους μέσω τεχνικών ενισχυτικής μάθησης. Το νέο επίτευγμα υποδεικνύει ότι τα γλωσσικά μοντέλα μπορούν να προγραμματίσουν τα βάρη εντελώς στοχευμένα, προσφέροντας ταυτόχρονα τεράστια οφέλη στην απόδοση αλλά και εγείροντας άμεσα σοβαρά ερωτήματα για την ασφάλεια των μελλοντικών δομών λογισμικού.
Αν κάποιος ζητούσε από έναν κορυφαίο μηχανικό λογισμικού να δημιουργήσει χειροκίνητα τις μαθηματικές τιμές για ένα νευρωνικό δίκτυο που παίζει το παιχνίδι Go, το εγχείρημα θα αποτύγχανε παταγωδώς. Οι άνθρωποι στερούνται τη βιολογική δυνατότητα να αναλύσουν εκατομμύρια δεκαδικούς αριθμούς και να χαρτογραφήσουν στο μυαλό τους την πολύπλοκη αλληλεπίδρασή τους. Η μηχανή, ωστόσο, απέδειξε ότι διαθέτει αυτήν ακριβώς τη δυνατότητα ερμηνείας.
Τι είναι το Weight-Space Programming και πώς λειτουργεί;
Το Weight-Space Programming αποτελεί μια νέα μέθοδο όπου προηγμένα γλωσσικά μοντέλα, όπως το GPT-6 Astra, διαβάζουν και τροποποιούν απευθείας τα βάρη ενός νευρωνικού δικτύου χωρίς να απαιτείται η κλασική διαδικασία επανεκπαίδευσης. Η προσέγγιση επιτρέπει τη στοχευμένη διόρθωση σφαλμάτων συλλογισμού, αναλύοντας τα αριθμητικά δεδομένα της αρχιτεκτονικής του μοντέλου αποκλειστικά μέσω εντολών φυσικής γλώσσας.
- Ανάγνωση ακατέργαστων δεδομένων: Το GPT-6 Astra δέχεται τεράστιες λίστες δεκαδικών αριθμών ως είσοδο κειμένου και εντοπίζει ποια ακριβώς διεργασία εκτελεί η κάθε συστάδα νευρώνων.
- Απουσία βελτιστοποιητών: Ολόκληρη η διαδικασία εκτελείται χωρίς να χρησιμοποιηθεί κάθοδος κλίσης (gradient descent) ή κλασικοί συμβολικοί βελτιστοποιητές της μηχανικής μάθησης.
- Χρήση καθαρού συλλογισμού: Ο εντοπισμός και η διόρθωση σφαλμάτων βασίζεται στην ικανότητα λογικής αφαίρεσης του κεντρικού γλωσσικού μοντέλου.
Κάθε μοντέλο βασίζεται σε δισεκατομμύρια παραμέτρους (βάρη), οι οποίες προσαρμόζονται σταδιακά αναλύοντας αδιανόητους όγκους δεδομένων, ώστε το σύστημα να μάθει να αναγνωρίζει μοτίβα. Όταν προκύπτει κάποιο σφάλμα, οι ερευνητές υποχρεούνται να καταφύγουν σε νέο, δαπανηρό κύκλο εκπαίδευσης (fine-tuning). Η επιστημονική ομάδα του MIT απέδειξε ότι το Astra εντοπίζει τις προβληματικές μαθηματικές συνδέσεις διαβάζοντας τα βάρη σαν να ήταν παραδοσιακός κώδικας προγραμματισμού.
Η επέμβαση στο Qwen3.5-0.8B της Alibaba
Οι επιστήμονες δοκίμασαν τις πραγματικές δυνατότητες του Astra πάνω στο μικρό γλωσσικό μοντέλο Qwen3.5-0.8B, το οποίο έχει αναπτύξει η κινεζική εταιρεία Alibaba. Ζητήθηκε από το σύστημα της OpenAI να βελτιώσει τις επιδόσεις του Qwen στην επίλυση μαθηματικών προβλημάτων, εντοπίζοντας την πηγή μιας αδυναμίας που οδηγούσε τον αλγόριθμο σε ατέρμονους, λανθασμένους βρόχους λογικής. Το Astra εντόπισε το ακριβές σημείο της δυσλειτουργίας και προχώρησε σε χειροκίνητη διόρθωση μόλις του 0,016% των παραμέτρων του κινεζικού συστήματος.
Το αποτέλεσμα υπήρξε απολύτως μετρήσιμο και ταυτόχρονα τρομακτικό. Η βαθμολογία του Qwen στο αυστηρό benchmark MATH-500 εκτοξεύτηκε από το πενιχρό 7,9% στο εντυπωσιακό 48,1%. Παράλληλα, το σύστημα παρουσίασε τριπλασιασμό της απόδοσής του στην κλίμακα IFEval (Instruction Following Evaluation), επιδεικνύοντας πολύ καλύτερη ικανότητα να ακολουθεί πιστά τις εντολές του χρήστη. Ολόκληρη η διαδικασία ολοκληρώθηκε σε ελάχιστο χρόνο, εξοικονομώντας τεράστια ποσά υπολογιστικής ενέργειας.
Αναγνώριση πολύπλοκης συμπεριφοράς από ακατέργαστα δεδομένα
Ένα εξίσου κρίσιμο σκέλος της έρευνας επικεντρώθηκε στην ικανότητα του μοντέλου να κατανοεί τη δομή δικτύων από την απλή ανάγνωση των αριθμητικών τιμών. Οι ερευνητές εκπαίδευσαν μικρά δίκτυα μέσω αλγορίθμων ενισχυτικής μάθησης (PPO) για να παίζουν κλασικά βιντεοπαιχνίδια, συμπεριλαμβανομένων των Breakout, Pong και Pac-Man. Αμέσως μετά, παρουσίασαν στο GPT-6 Astra αποκλειστικά τα 17.253 βάρη της αρχιτεκτονικής ως σκέτο κείμενο, ζητώντας του να αναγνωρίσει τον τίτλο του βιντεοπαιχνιδιού.
Παρά την πλήρη απουσία οποιασδήποτε άλλης περιγραφικής πληροφορίας, το εργαλείο της OpenAI ανέλυσε τις μαθηματικές συνδέσεις που αντιστοιχούσαν στην κίνηση των αντικειμένων μέσα στο ψηφιακό περιβάλλον και αναγνώρισε με ακρίβεια το κάθε παιχνίδι. Ανακάλυψε για παράδειγμα ότι η ρακέτα στο παιχνίδι Breakout αντιστοιχούσε σε συγκεκριμένα νευρώνια στην τελευταία σειρά του πίνακα βαρών. Η ικανότητα ερμηνευσιμότητας σε τέτοιο βάθος αποτελεί κάτι που η ανθρώπινη κοινότητα δεν έχει κατακτήσει.
Διαβάστε επίσης
Ποιοι κίνδυνοι κρύβονται πίσω από την αναδρομική αυτοβελτίωση;
Η ικανότητα ενός συστήματος τεχνητής νοημοσύνης να αναβαθμίζει αυτόνομα άλλες αρχιτεκτονικές ενέχει τον κίνδυνο δημιουργίας ευπαθειών που παραμένουν εντελώς αόρατες στους ερευνητές. Η συνεχής συσσώρευση μη ελεγχόμενων παρεμβάσεων στον πυρήνα των νευρωνικών δικτύων καθιστά εξαιρετικά δύσκολη την αξιολόγηση και τον περιορισμό ανεπιθύμητων, επικίνδυνων συμπεριφορών στις μελλοντικές γενιές λογισμικού.
- Τα μοντέλα ενδέχεται να εισαγάγουν ακούσια κενά ασφαλείας στα μικρότερα συστήματα που καλούνται να αναβαθμίσουν.
- Η μαθηματική πολυπλοκότητα των παρεμβάσεων εμποδίζει τον πλήρη έλεγχο από τους ανθρώπους επόπτες, δημιουργώντας «μαύρα κουτιά» κώδικα.
- Οι κύκλοι αυτοβελτίωσης επιταχύνουν ραγδαία τον ρυθμό ανάπτυξης, δυσχεραίνοντας την εφαρμογή των ρυθμιστικών πλαισίων (όπως το AI Act της ΕΕ).
Η δημοσίευση του MIT έρχεται να επιβεβαιώσει με τον πιο ξεκάθαρο τρόπο τις ανησυχίες που εξέφρασε ο CEO της Anthropic, Dario Amodei. Μέσα από το αναλυτικό δοκίμιό του με τίτλο We Must Pace the Frontier, ο Amodei υποστήριξε σθεναρά την άμεση ανάγκη να επιβραδυνθεί ο ρυθμός ανάπτυξης των κορυφαίων μοντέλων, προκειμένου να διασφαλιστεί η σωστή ευθυγράμμισή τους με τις ανθρώπινες αξίες. Η έννοια της «αναδρομικής αυτοβελτίωσης» περιγράφει ακριβώς τη δυνατότητα των μηχανών να σχεδιάζουν μόνες τους την επόμενη, πολύ πιο ικανή γενιά συστημάτων. Αν και η παρέμβαση του GPT-6 Astra στο μοντέλο της Alibaba δεν αποτελεί τον απόλυτο, τελικό ορισμό της αναδρομικής αυτοβελτίωσης, αποτελεί το πιο καθοριστικό βήμα προς αυτή την κατεύθυνση.
Οι επιστήμονες προειδοποιούν ότι εάν τα μοντέλα αρχίσουν να παραμετροποιούν ελεύθερα το ένα το άλλο, τα ερευνητικά κέντρα θα χάσουν γρήγορα τη δυνατότητα να χαρτογραφούν τις λειτουργίες τους. Η αδιαφάνεια αυτών των αλλαγών ίσως γεννήσει δυσλειτουργίες οι οποίες θα παραμένουν αδρανείς μέχρι να ενεργοποιηθούν σε πραγματικό, κρίσιμο περιβάλλον.

Διαβάστε επίσης
