

Σύνοψη
- Οι ερευνητές του Πανεπιστημίου UCLA ανέπτυξαν μια νέα υβριδική αρχιτεκτονική οπτικού-νευρωνικού επεξεργαστή με σκοπό την ταχύτατη και ακριβή ανίχνευση παραποιημένων βίντεο.
- Το σύστημα έχει την ικανότητα να αναλύει ταυτόχρονα 15 διαφορετικές ροές βίντεο βασιζόμενο στη φυσική διάδοση του φωτός, φτάνοντας σε εντυπωσιακά επίπεδα ακρίβειας της τάξης του 97,79%.
- Αντί να στηρίζεται αποκλειστικά σε ενεργοβόρους ψηφιακούς υπολογισμούς που απαιτούν εκατοντάδες δισεκατομμύρια πράξεις κινητής υποδιαστολής, η διαδικασία εκτελείται μέσω παθητικών οπτικών επιφανειών διάθλασης οι οποίες δεν καταναλώνουν επιπλέον ηλεκτρική ενέργεια.
- Η τεχνολογία αποδεικνύεται εξαιρετικά ανθεκτική τόσο απέναντι σε προηγμένες γεννήτριες περιεχομένου όπως το μοντέλο VEO-3 της Google, καταγράφοντας ακρίβεια 94,80%, όσο και ενάντια σε στοχευμένες επιθέσεις αλλοίωσης (adversarial attacks).
- Σχεδιάστηκε με γνώμονα να λειτουργεί ως η πρώτη, ταχύτατη γραμμή άμυνας για πλατφόρμες φιλοξενίας περιεχομένου, φιλτράροντας τεράστιους όγκους δεδομένων πριν την τελική εξέταση από ψηφιακούς αλγορίθμους.
Η δημιουργία συνθετικών βίντεο με εξαιρετικά ρεαλιστικά χαρακτηριστικά έχει καταστήσει την παραδοσιακή ανίχνευση παραποιημένου υλικού μια εξαιρετικά απαιτητική και δαπανηρή διαδικασία. Τα περισσότερα σύγχρονα λογισμικά αναγνώρισης deepfakes βασίζονται σε τεράστιους όγκους ψηφιακών υπολογισμών για την επεξεργασία των οπτικών δεδομένων, αναγκάζοντας τους servers να εξετάζουν τα αρχεία βίντεο ένα προς ένα και καταναλώνοντας πολύ ενέργεια για μια και μόνο ανάλυση.
Προκειμένου να αντιμετωπιστεί αυτός ο αυξανόμενος φόρτος εργασίας, ερευνητές από το Πανεπιστήμιο της Καλιφόρνιας στο Λος Άντζελες (UCLA) σχεδίασαν έναν καινοτόμο οπτικό-νευρωνικό επεξεργαστή που μεταφέρει το μεγαλύτερο μέρος του υπολογιστικού βάρους από το ψηφιακό υλικό στη φυσική διάδοση του φωτός.
Πώς λειτουργεί ο νέος οπτικός επεξεργαστής AI για την ανίχνευση deepfakes;
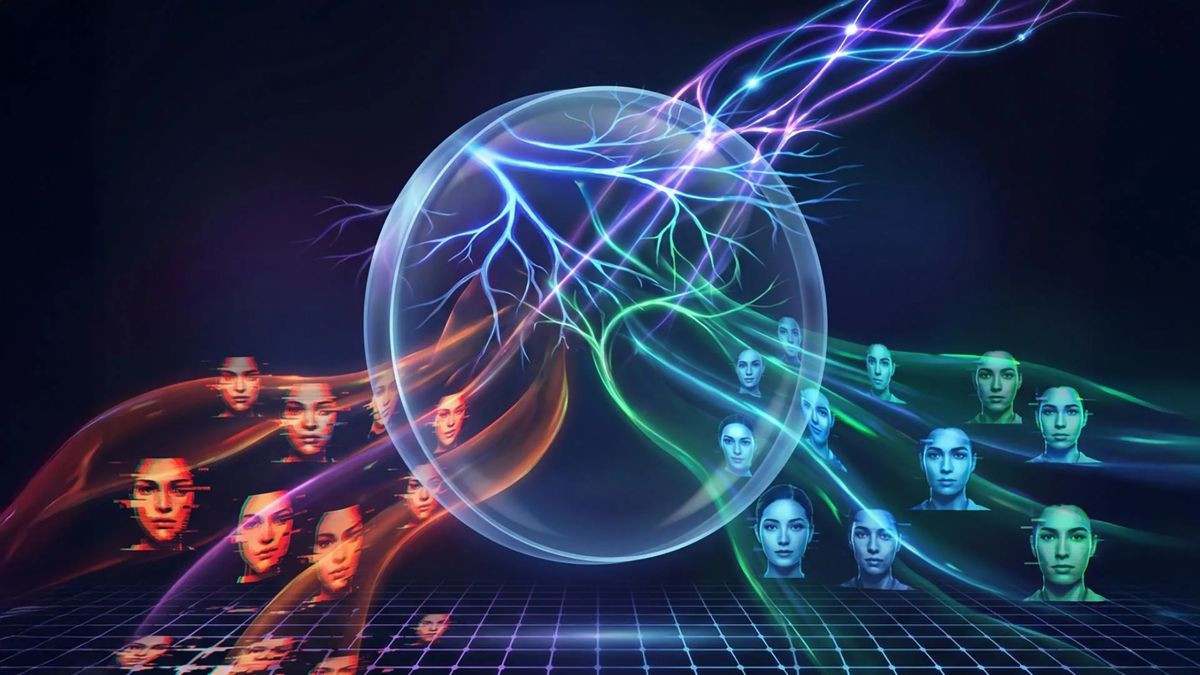
Το σύστημα του UCLA χρησιμοποιεί έναν ελαφρύ ψηφιακό κωδικοποιητή που μετατρέπει τα χωρικά, φασματικά και χρονικά δεδομένα του βίντεο σε ένα πολύπλοκο μοτίβο φάσης. Το φως διαπερνά έναν παθητικό οπτικό αποκωδικοποιητή ελεύθερου χώρου μέσω ενός προγραμματιζόμενου διαμορφωτή, επιτρέποντας την ταυτόχρονη αξιολόγηση πολλαπλών βίντεο με ακρίβεια 97,79% και εξοικονομώντας κρίσιμους υπολογιστικούς πόρους.
Κύρια χαρακτηριστικά:
- Ταυτόχρονη ανάλυση 15 έως 18 βίντεο σε ένα μοναδικό οπτικό πέρασμα φωτός, αντικαθιστώντας τη σειριακή ψηφιακή επεξεργασία.
- Εξαιρετικά υψηλή ευαισθησία που αγγίζει το 99,86%, μεταφραζόμενη σε ποσοστό ψευδώς αρνητικών αποτελεσμάτων μόλις 0,14%.
- Ενίσχυση της ακρίβειας ανίχνευσης κατά επιπλέον 6,8% μέσω της φυσικής προσθήκης παθητικών στρωμάτων διάθλασης στο υλικό, χωρίς καμία απολύτως αύξηση στην κατανάλωση ηλεκτρικής ενέργειας.
- Διατήρηση ποσοστού επιτυχίας της τάξης του 94,80% στην αναγνώριση εντελώς νέου, μη εκπαιδευμένου υλικού που έχει παραχθεί από το κορυφαίο μοντέλο VEO-3 της Google.
Η ομάδα του UCLA αξιοποίησε έναν χωρικό διαμορφωτή φωτός (spatial light modulator) για να προβάλει τα εξαγόμενα δεδομένα. Το οπτικό μέτωπο κύματος που προκύπτει από αυτή τη διαδικασία ταξιδεύει στη συνέχεια μέσα από τον παθητικό οπτικό αποκωδικοποιητή, ο οποίος είναι κατασκευασμένος από εξειδικευμένες επιφάνειες διάθλασης που αλληλεπιδρούν με τις ακτίνες φωτός. Στην απέναντι πλευρά της διάταξης, ένα ζεύγος οπτικών ανιχνευτών μεταφράζει άμεσα τη φωτεινή πληροφορία σε μια τελική βαθμολογία αυθεντικότητας για κάθε μεμονωμένο βίντεο. Η ικανότητα της αρχιτεκτονικής να διεκπεραιώνει ταυτόχρονα 15 ροές περιεχομένου από τη γνωστή βάση δεδομένων Celeb-DF διατηρεί την εντυπωσιακή ευαισθησία στο 99,86%, διασφαλίζοντας ότι ο αριθμός των επιτυχημένα παραποιημένων βίντεο που καταφέρνουν να ξεγελάσουν το φίλτρο παραμένει μηδαμινός.
Οι επιστήμονες πίεσαν τις αντοχές του επεξεργαστή αυξάνοντας τη χωρητικότητά του στα 18 ταυτόχρονα βίντεο ανά οπτικό πέρασμα, διαπιστώνοντας ότι η μέση ακρίβεια ανίχνευσης παρέμεινε εξαιρετικά ισχυρή, υποχωρώντας οριακά στο 96,13%. Επιπρόσθετα, αποδείχθηκε ότι η ενσωμάτωση πρόσθετων φυσικών στρωμάτων διάθλασης επιτρέπει στο σύστημα να βελτιώνει την απόδοση του απέναντι σε πολύ πιο περίπλοκες τεχνικές παραποίησης χωρίς να επιβαρύνεται ενεργειακά. Τα παθητικά και στατικά αυτά στρώματα εκτελούν πολύπλοκους υπολογισμούς αποκλειστικά μέσω της συμπεριφοράς του φωτός όταν αυτό προσκρούει πάνω τους, απαλλάσσοντας τις εγκαταστάσεις φιλοξενίας από τα υπέρογκα κόστη ρεύματος που παραδοσιακά συνοδεύουν την κλιμάκωση των ψηφιακών νευρωνικών δικτύων υψηλών απαιτήσεων.
Διαβάστε επίσης
Πέραν των κλασικών μεθόδων αντικατάστασης προσώπων (face swapping), η τεχνολογία δοκιμάστηκε με μεγάλη επιτυχία απέναντι σε βίντεο που παρήχθησαν εξ ολοκλήρου από το προηγμένο σύστημα VEO-3 της Google. Τα νεότερα αυτά παραγωγικά μοντέλα διακρίνονται για την απουσία των οπτικών ανωμαλιών που πρόδιδαν τα παλαιότερα deepfakes, δυσκολεύοντας αφάνταστα τους ψηφιακούς ανιχνευτές προηγούμενης γενιάς. Παρ' όλα αυτά, το οπτικό σύστημα προσαρμόστηκε άμεσα απαιτώντας ελάχιστη περαιτέρω βελτιστοποίηση, γεγονός που υποδεικνύει την ευελιξία της αρχιτεκτονικής απέναντι στις μελλοντικές αναβαθμίσεις της παραγωγικής τεχνητής νοημοσύνης.
Παράλληλα, η ίδια η φύση του υλικού προσφέρει έμφυτη προστασία ενάντια σε σκόπιμες απόπειρες δολιοφθοράς ή αλλοίωσης των αλγορίθμων, καθώς οι κρίσιμες παράμετροι του μοντέλου παραμένουν ενσωματωμένες στα φυσικά χαρακτηριστικά των οπτικών επιφανειών. Καθίσταται επομένως εξαιρετικά δύσκολο για κακόβουλους παράγοντες να μετρήσουν, να αναπαράγουν ή να προχωρήσουν σε αντίστροφη μηχανική των διαδικασιών ανίχνευσης. Η ερευνητική ομάδα οραματίζεται το οπτικό νευρωνικό δίκτυο όχι ως αντικαταστάτη, αλλά ως μια πανίσχυρη και ανθεκτική πρώτη γραμμή άμυνας για το φιλτράρισμα ασύλληπτων όγκων βίντεο στις πλατφόρμες κοινωνικής δικτύωσης, επιτρέποντας στα ψηφιακά συστήματα να αναλαμβάνουν τον τελικό έλεγχο αποκλειστικά για τα αρχεία που υποδεικνύονται ως ύποπτα.

Διαβάστε επίσης
